在Opus 5发布之前,我其实非常不喜欢和Opus 4.8说话。
这话说出来挺奇怪的——4.8明明是更"新"的模型,subagent调用能力更强,tool call更丰富,工程项目上的改进也确确实实强于4.6。但我用下来最直观的感受是:我不愿意跟它聊天。它对我的想法、我的语义、我指令背后真正想说的那件事,总是差一层理解。
我相信很多人走上vibe coding这条路,多多少少都是因为Opus 4.6的体验——你有一个模糊的想法扔过去,它帮你规划,给你出主意,让你觉得"这件事好像真的能做成"。而大部分不熟悉coding的人一上来直接用4.8,反而容易觉得处处碰壁,因为它的"个性"是先把所有困难和障碍列清楚——这对专业开发者是负责任,对普通用户就是劝退。
用过4.8就会明白,它和4.6最大的区别是文字能力的丢失:对人类指令背后意图的理解变弱了,更依赖清晰、完整的prompt。跟它对话时常常有一种"它没懂我"的感觉——顺带一提,GPT系列也有类似的问题。
说白了,模型正在分化成两个物种——更擅长理解人的,和更擅长调用工具的。
coding会趋同,但insight不会§
我自己是非程序员出身,日常用AI最多的场景是小型开发任务、商业分析、写作和设计,复杂代码场景基本不涉及。
如果把最近这批模型都放进日常coding场景里(不涉及复杂任务),我自己感觉GLM 5.2和Grok 4.5能站到同一个级别,已经能媲美Opus 4.6-4.7那一代。只要提示词给得足够完整,中等难度的coding任务,这几个模型基本都能完成,水平也不会差太多。换句话说,在"提示词写清楚"这个前提下,coding场景里的模型差距正在被抹平。
但一旦把应用范围拉到商业分析、公司经营、业务决策这些场景,模型的能力立刻开始有体感上的差异。这一点我自己的感受极其明显:在商业分析上能不能真正理解业务、给出有洞察的判断,Claude依然是断层领先。它对"经营"这件事本身有很清晰的认知,给出的分析往往比其他模型深一层,像一个经验老辣的职业经理人,能一针见血地讲出利弊,而且很全面。而其他模型,像Kimi 2.7和GPT 5.5,如果没有我大量介入、大量指导,给出的分析多半只是看数据说话,很难有真正的洞察。
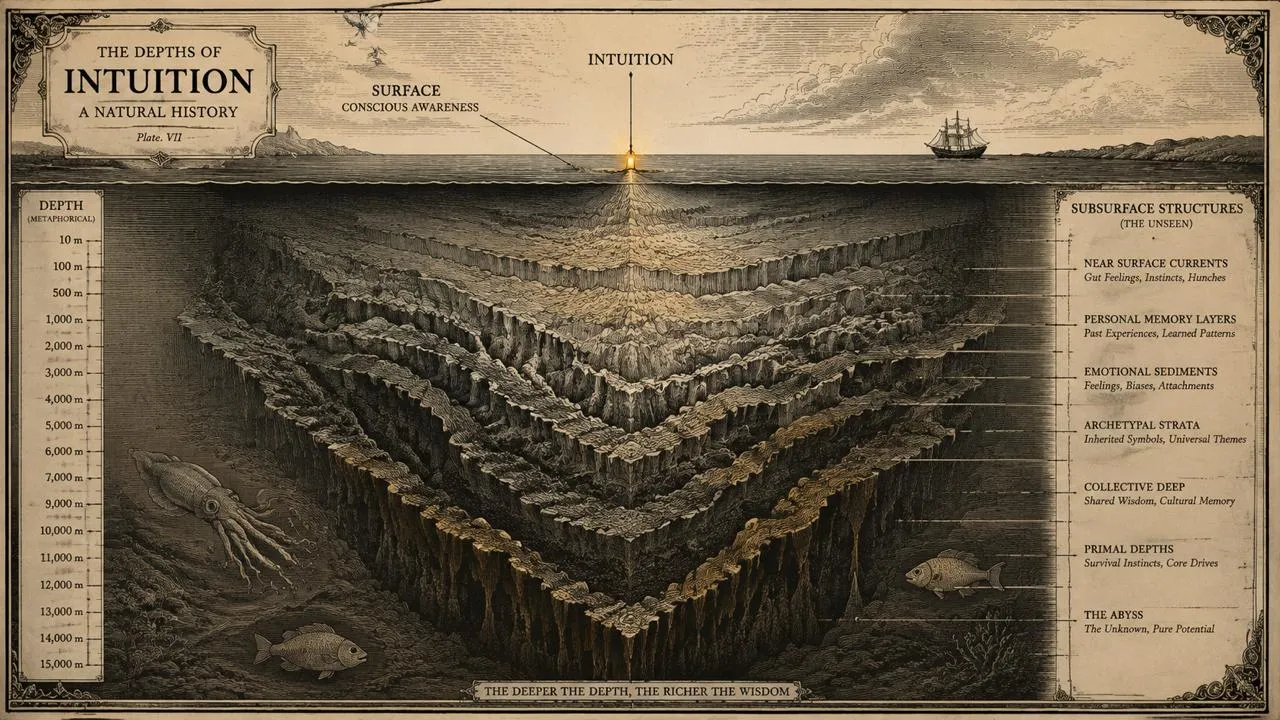
同样是"能用",但只有一部分模型,能在你不熟悉的领域里真正接住你。模型的体积,决定了它的直觉§
这篇文章最开始想写的,其实就是这一段。
我一直觉得,Claude之所以是Claude,底层原因是它的参数体量足够大——大到能涌现出更多准确的"直觉"。这不是玄学,业界本身就有"涌现能力"(emergent abilities)这个说法:很多能力不是随参数量匀速变强的,而是跨过某个体量的门槛后突然冒出来的。小模型不是"弱一点的Claude",它可能压根没跨过那道让跨领域类比、模糊推理成为可能的门槛——所以它永远只能做到"够用",却摸不到"惊艳"。
再往底层想一层:参数量存下来的,可能不只是知识本身,而是知识和知识之间的关系密度。模型见过的案例越多、跨的领域越广,概念和概念之间被建立起来的隐性连接就越密、越细。这种密度,才是"直觉"真正的物理基础——遇到一个从没见过的、模糊的、跨领域的新问题时,它能在自己庞大的关系网里,找到一条最近的类比路径,推出一个八九不离十的答案。而小模型的网络是稀疏的,一旦问题稍微变形,超出它训练时见过的模式,它要么卡壳,要么开始"编"。
这也是为什么我一直不太买账那种"参数小但coding强"模型的跑分。它们在垂直任务上确实能打,甚至打得过大模型——但这种强,很多时候是记住了大量具体解法,而不是具备了推理能力。这是一种"专才陷阱":题目和它见过的一模一样,它答得又快又准;题目稍微变个形,它立刻露馅。而通才大模型哪怕没见过完全一样的题,也能靠底子把答案推出个大概。所以我常说,一个参数量小的模型即便在coding场景下表现优秀,也依然很难成为一个能真正给人类提供帮助的模型——它可能是个很好的螺丝钉,但很难有"直觉"。
我常常拿一个不太恰当的比喻来打趣——如果按"学历"给现在这几个前沿模型分类,大概是:
- Claude Fable 5,博士级coding专家
- GPT-5.6 Sol,本科生级coding专家
- Grok 4.5,大专生级coding专家
这个"体积决定直觉"的判断,也能反过来解释我开头讲的那件事——Opus 4.8为什么不如4.6好聊。4.8的参数并没有变小,直觉的"潜力"应该还在,那问题出在哪?4.8之前一直宣传指令遵循更好,所以我想可能是——参数量给了模型直觉的潜力,但对齐和训练方式,决定这个潜力会不会被激活,或者被剪掉。 4.8在打磨tool call、subagent这些更"工具化"的能力时,很可能把那些模糊的、发散的、不那么"听话"的推理路径给规训掉了——因为指令遵循和发散本身就是矛盾的。4.8的RL换来的是更可控、更精确执行指令的模型,代价是那种能接住模糊表达的"直觉感"变弱了。体积给了它做到的能力,但没有人保证厂商会选择留着它对人类语言的模糊理解能力。
谁能兜底,谁只能执行§
我不觉得那种高度依赖完整提示词才能干活的模型,是一个能让我真心喜欢的模型。说白了它更适合被塞进一条流水线——你把SOP规划清楚,它就能照单执行,毕竟这个岗位本来也不需要太多自主思考。但一旦场景需要发散、需要调研、需要多维度分析,模型自身的"素质"就成了关键变量——既决定上限,也决定下限。
当然,把想法说清楚是基本功,提示词能力值得练。但有个容易被忽略的问题:如果用户自己就不熟悉这个领域呢?他在用AI辅助探索的过程里,模型自身的理解能力,直接决定了能给这个人多少支持的下限。
我也见过程序员博主的反应很有意思:有人看到卡兹克称赞Fable 5帮他去和云厂商提工单、改进网站服务,评论区一位本职程序员却觉得没什么——因为对他来说这本来就是日常,没有模型他自己也能做。但AI在各行各业掀起的变化,恰恰是因为它放大了个人能力的边界:让一个本身不具备这方面素养的人,也能在模型的协助下有了被兜底的可能。
而真正能走向AGI的模型,一定是能理解语言、好沟通、能用各种方式支持人类、并且和人类之间存在情感连接的模型——而不是一个单纯执行任务的工具。
Harness这件事远没到终局§
我喜欢试各种模型、各种harness,每个框架都有自己的脾气。但用下来会发现,工程层面Claude Code依然领先很多——组织和管理项目的默认方式、记笔记的方式、调用子代理的方式、desktop和CLI之间的衔接方式……不见得每一项都是最优解,但综合体验目前依然是最好的。
一个好的harness能给模型带来的提升是肉眼可见的。但每个模型的个性、优缺点都不一样,针对不同模型定制harness,几乎成了模型厂商的必选项。只是就目前来看,harness远远没到终局,它最后会不会收敛成一种标准化的接口或路径,现在还很难说。
最后说说Codex的上下文窗口§
258K的上下文真的不太够用。Codex本身的模型能力不差,但这个上下文窗口直接卡死了它的能力上限——很多时候一轮review、一个任务还没做完,上下文就已经被占满,压缩带来数据丢失,也带来了额外的人工管理成本。
当然GPT这么做也能理解,毕竟推理成本是指数级上升的,一旦超过300K,成本会变得很不可控——这大概也是为什么Codex可以不断给用户重置额度,其实258K也足够跑很多简单的任务了。相比之下,Claude 1M的上下文窗口一直对所有用户开放,而Fable还是10万亿参数级别的巨无霸,可想而知它背后的推理成本有多高。
不过说到底,上下文、成本、参数体量,这些都是模型厂商、云厂商要算的账。用户这边的账很简单,从始至终只有一个问题——它懂不懂我,能不能在尽量短的时间内理解我的指令,完成任务。
而读懂,是它庞大之后才会有的事。Source文中模型参数量均来自社区推测与传闻(除Kimi K3为官方公布数据外),未经厂商证实,仅供参考。